前段时间分析一个电视直播网站时,我想弄清楚它的直播地址是怎么生成的。原以为从浏览器 Network 面板里复制链接就结束了,没想到链接还带着动态参数,直接请求又返回 403。
这篇文章把当时的排查过程重新整理一下。重点不在某个固定网站或一条长期可用的地址,而是如何从浏览器里找到请求、追踪参数生成逻辑,再还原页面正常发起请求时所需的上下文。
本文仅记录个人学习和调试过程,请在获得授权的环境中使用。直播地址、鉴权参数和站点脚本都可能随时变化。
先从 m3u8 请求入手
打开直播页面后,我先按 F12 进入开发者工具,在 Network 面板里搜索 m3u8。页面加载过程中出现了两个相关请求:
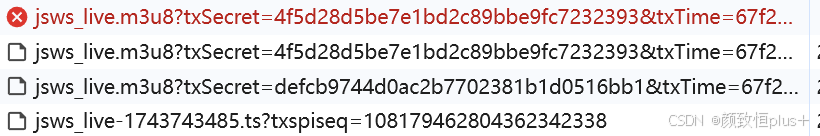
点开请求后可以看到,地址并不是一个固定链接,后面还带着 txSecret 和 txTime 两个参数:
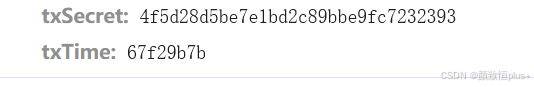
看到这里,直接复制地址显然不够。txTime 看起来和有效期有关,txSecret 则更像是根据路径和时间计算出来的签名。下一步就是找到前端在哪里生成它们。
在打包脚本里寻找参数来源
刷新页面后,我在 Sources 中全局搜索 txSecret。搜索结果并不多,关键逻辑集中在一个名为 299.d1f40516.js 的打包文件中:
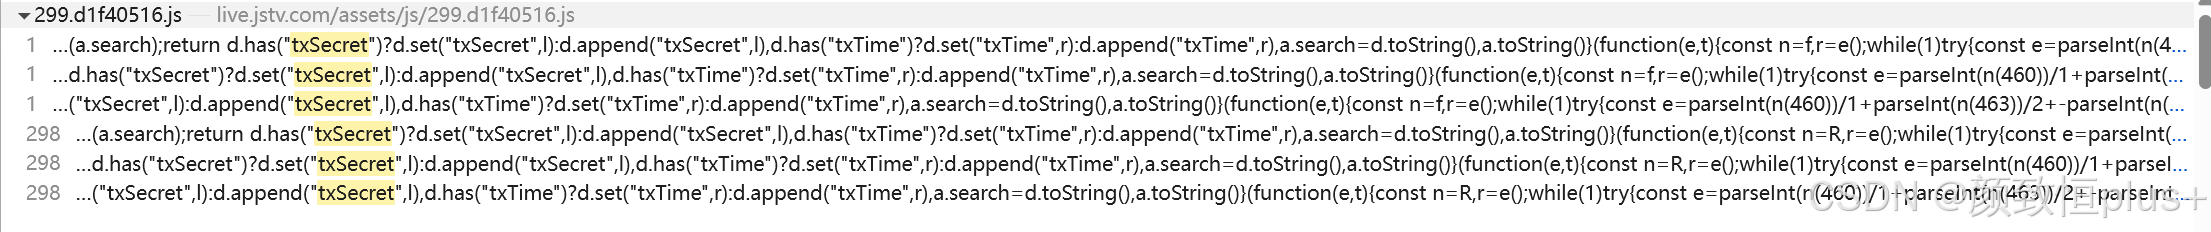
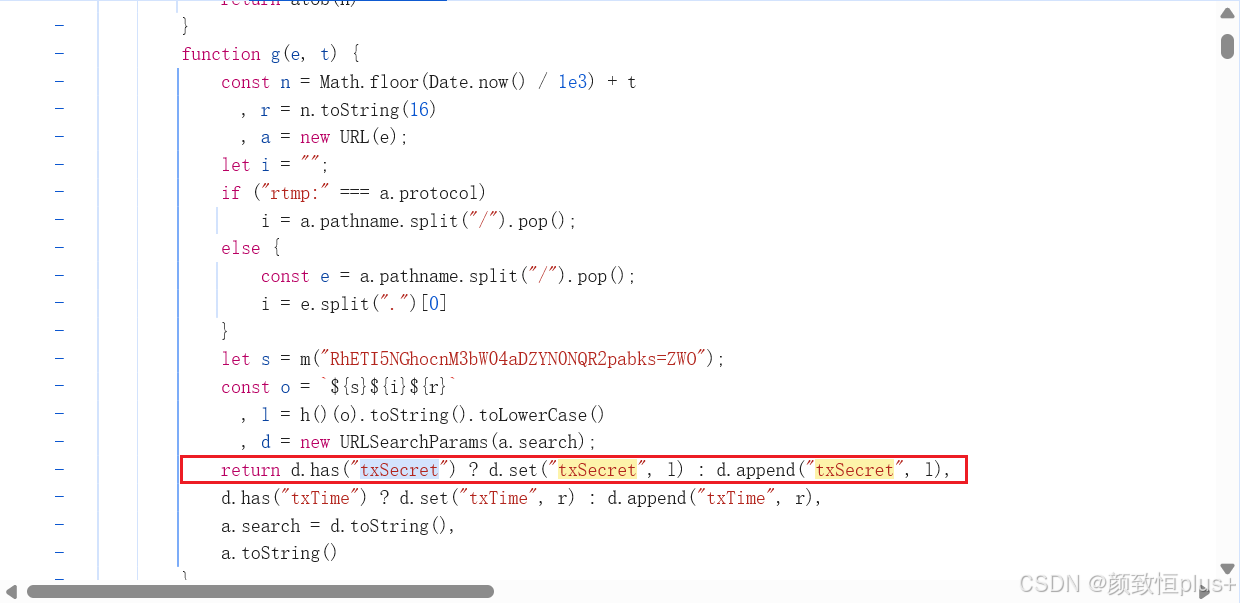
压缩后的代码不太好读,但搜索结果已经把范围缩得很小。沿着 txSecret 附近的调用往上看,可以找到拼接直播地址的函数。为了确认判断,我在这里加了断点:
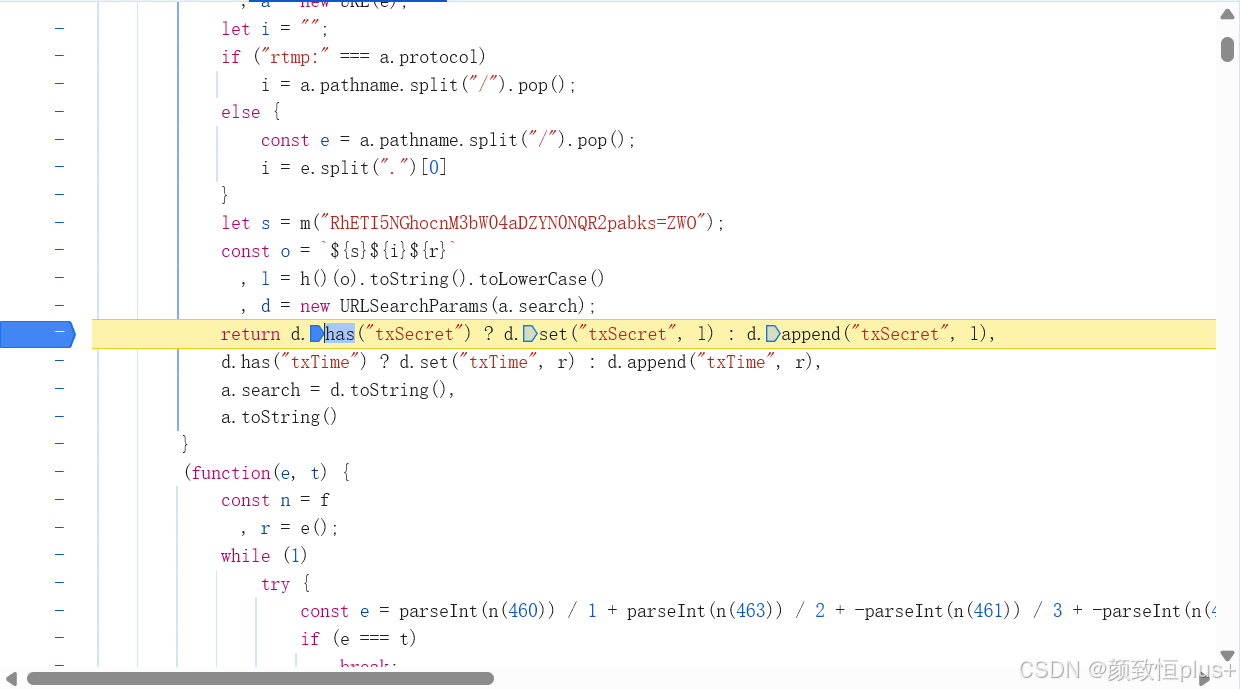
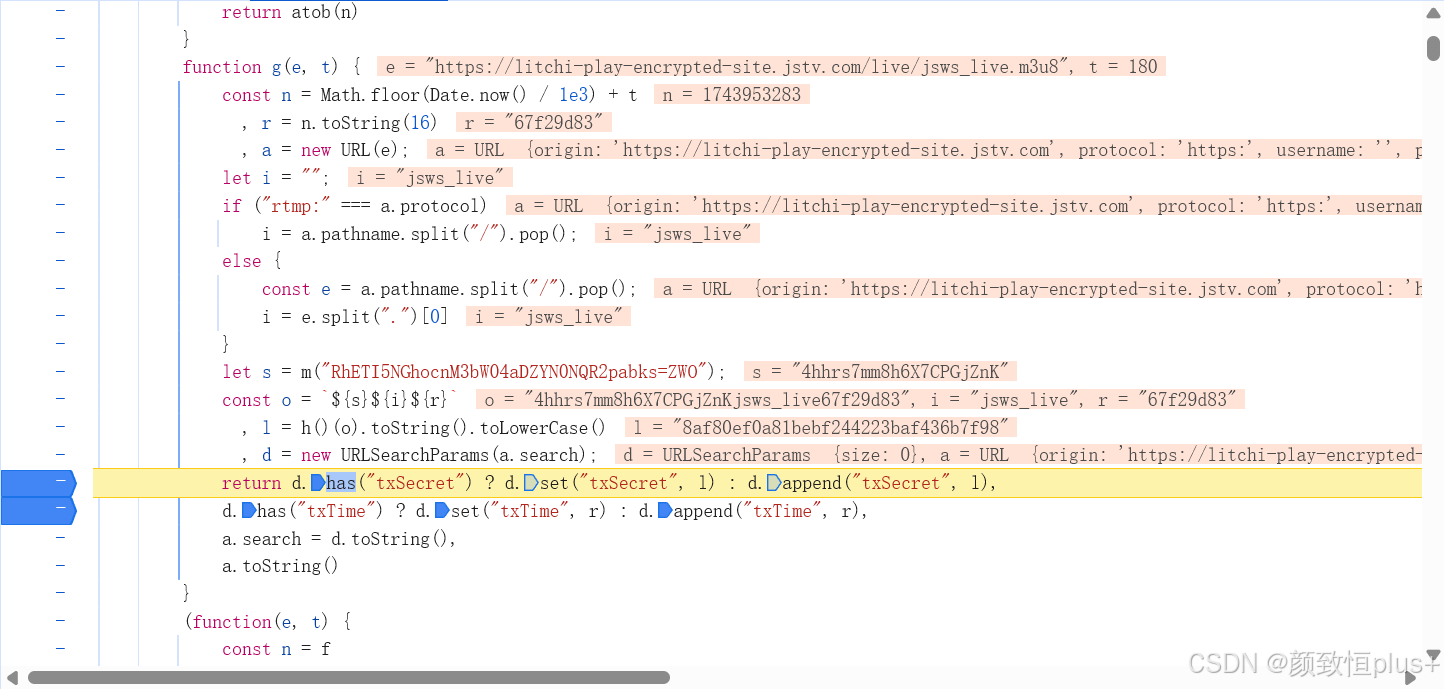
重新触发播放后,断点成功命中。从局部变量和返回值能看出来,这段函数最终生成的正是 Network 面板里看到的 m3u8 地址:
把生成逻辑单独跑起来
确认函数作用后,我把相关代码整理到本地,准备脱离网页单独运行:
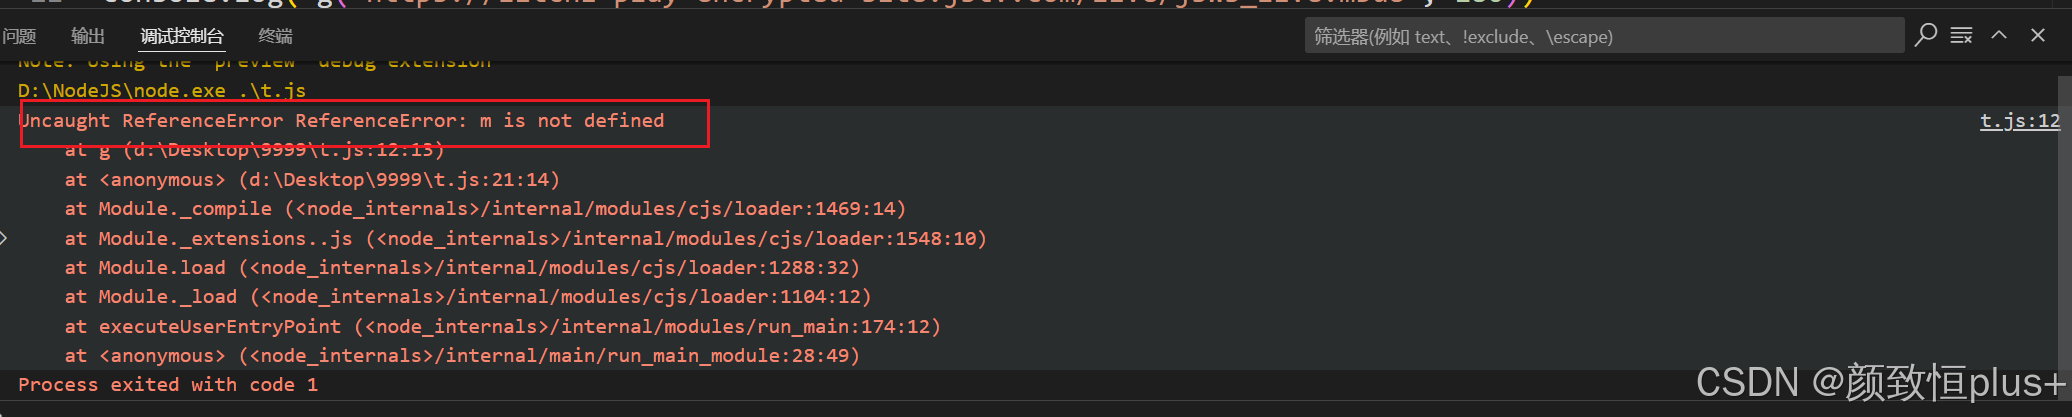
第一次运行并没有直接成功,代码提示缺少 m 函数。这很正常,因为打包产物中的函数往往依赖同一模块里的其他变量和方法。于是我回到断点位置,继续沿调用关系寻找 m:
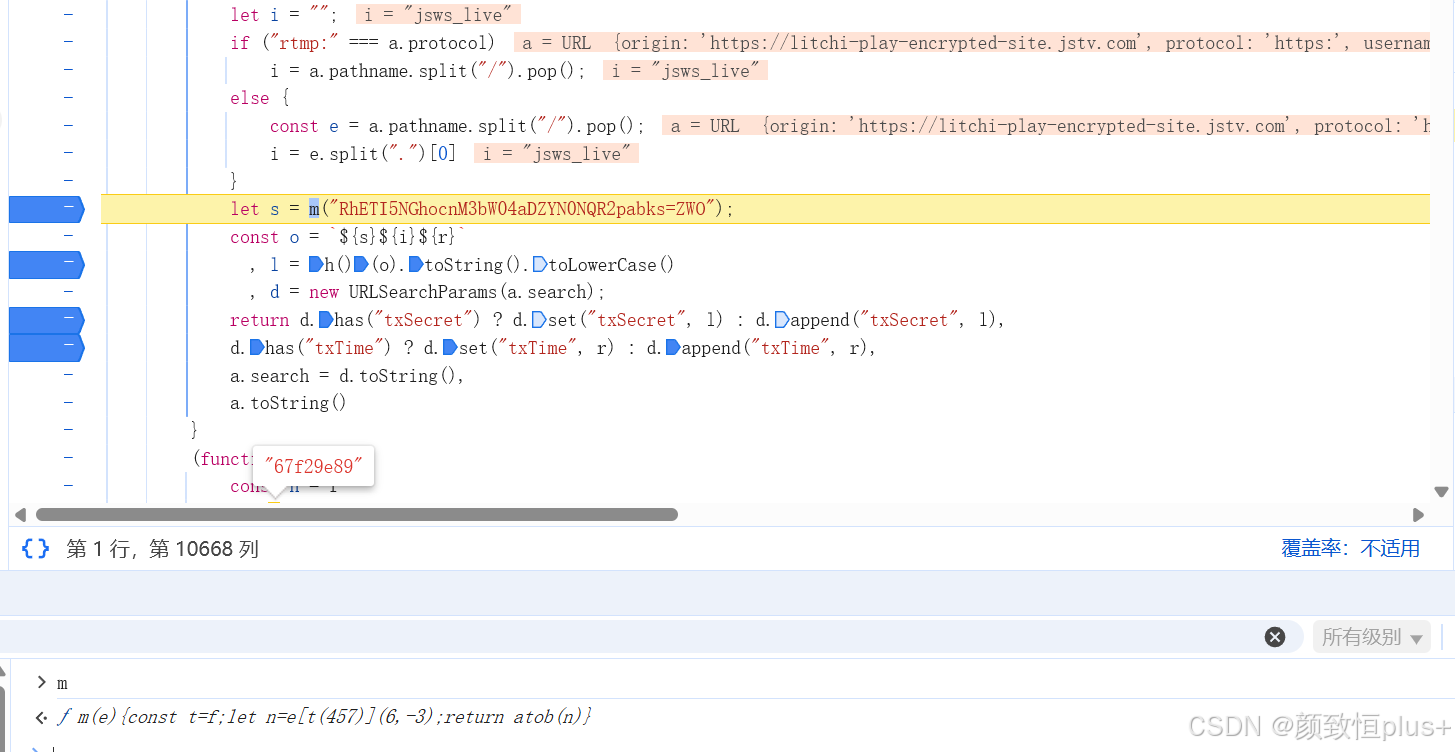
找到后继续补进本地代码:
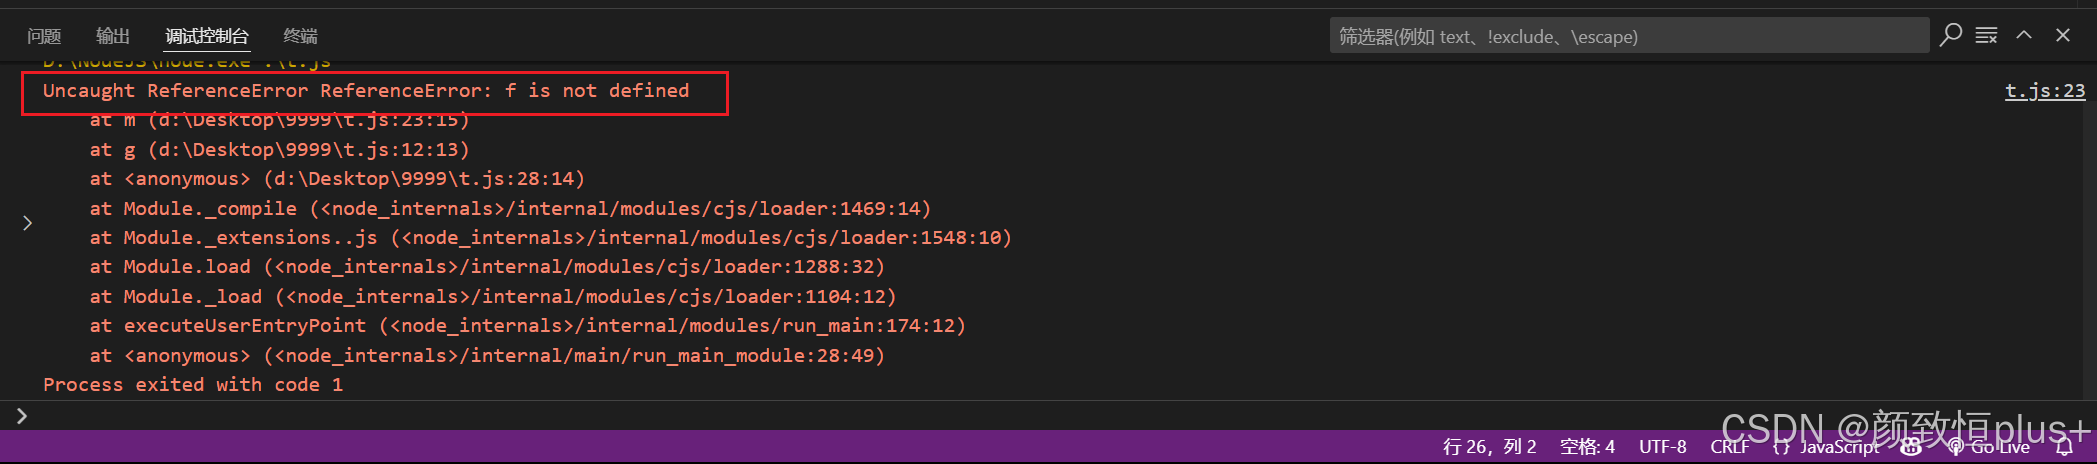
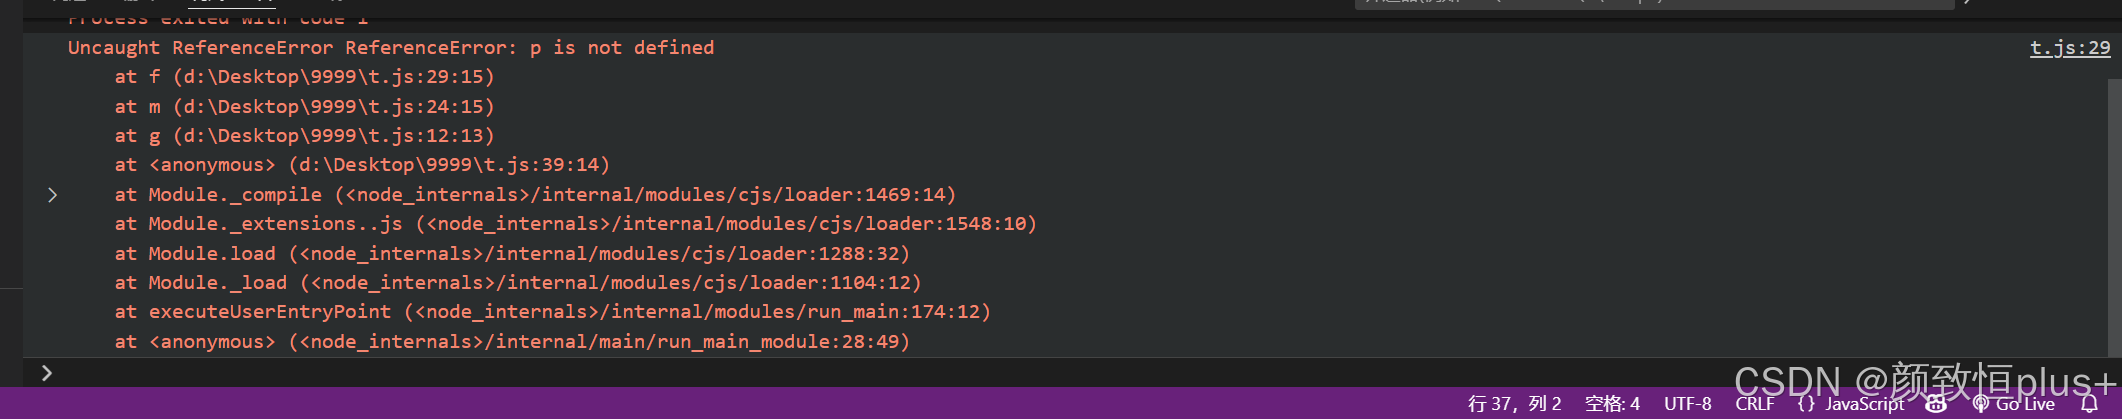
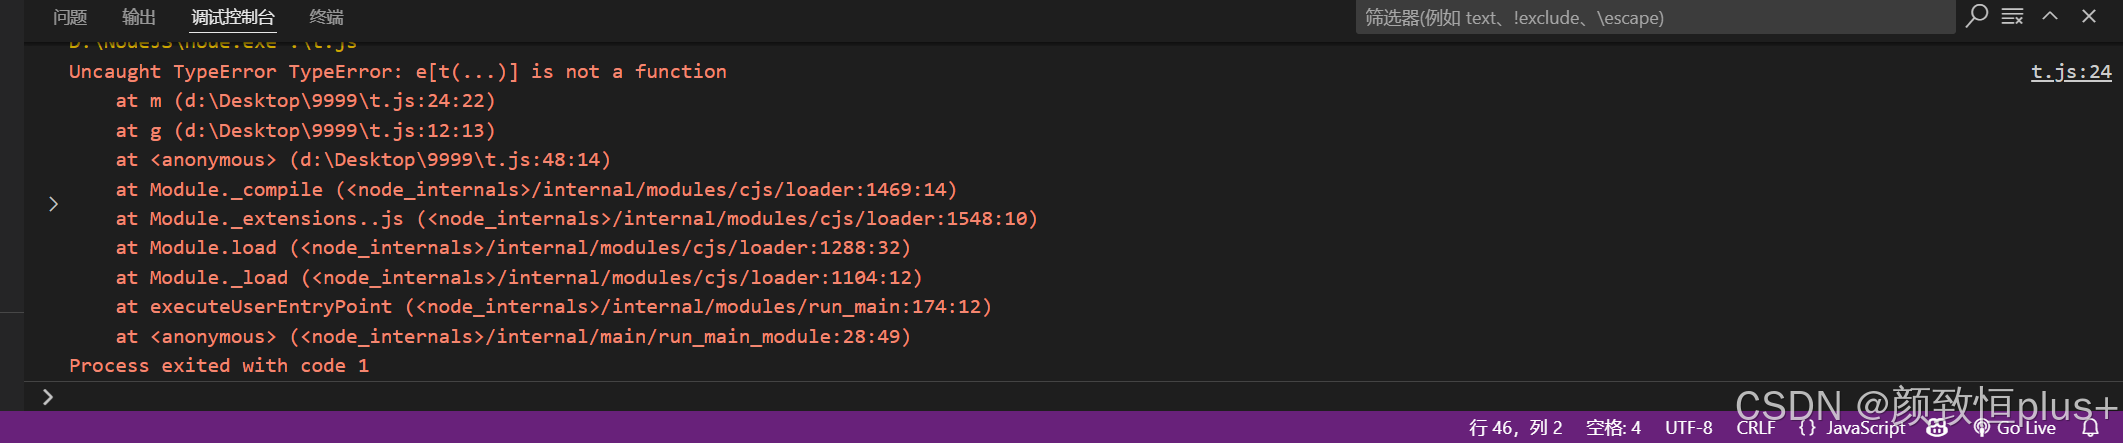
接下来又依次缺少 f 和 p。处理方式没有变化:不要凭函数名猜用途,而是回到浏览器里看变量来自哪个模块、传入了什么参数、最终返回什么结果。

识别打包器留下的调用方式
补齐几个函数后,新的错误变成了 e[t(...)] is not a function。这次不是简单少复制了一个函数,而是原代码还保留着打包器内部的模块调用方式:
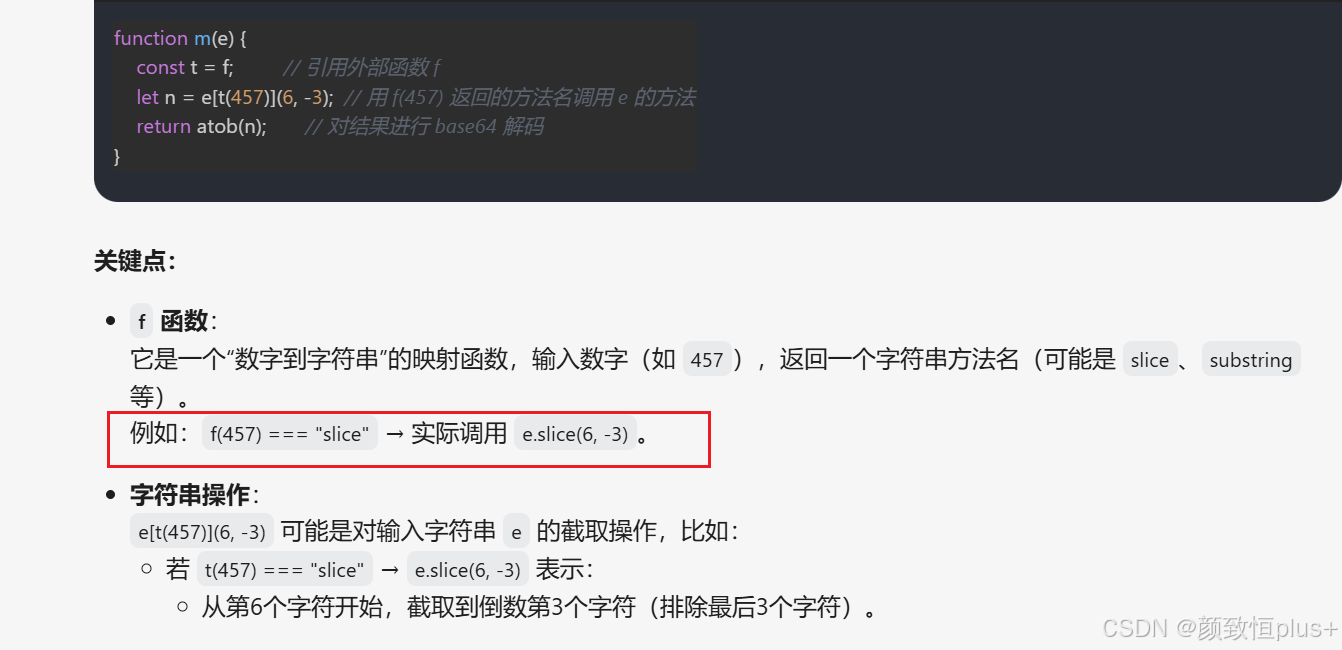
网页里的 e[...]、t(...) 依赖运行时模块表,直接放进一个独立脚本当然找不到对应函数。这里需要结合断点实际返回值,把打包器的间接调用还原成普通 JavaScript,而不是继续机械地复制代码。
其中一段逻辑类似:
l = h()(o).toString().toLowerCase()
继续观察输入和输出后,可以确认这里需要的是 MD5。放到 Node.js 中,可以用内置的 crypto 模块实现同样的行为:
const crypto = require('crypto')

function h() {
  return function (value) {
    return crypto.createHash('md5').update(value).digest('hex')
  }
}
把这部分替换掉,再补齐前面追踪到的依赖后,脚本终于能够生成完整地址:
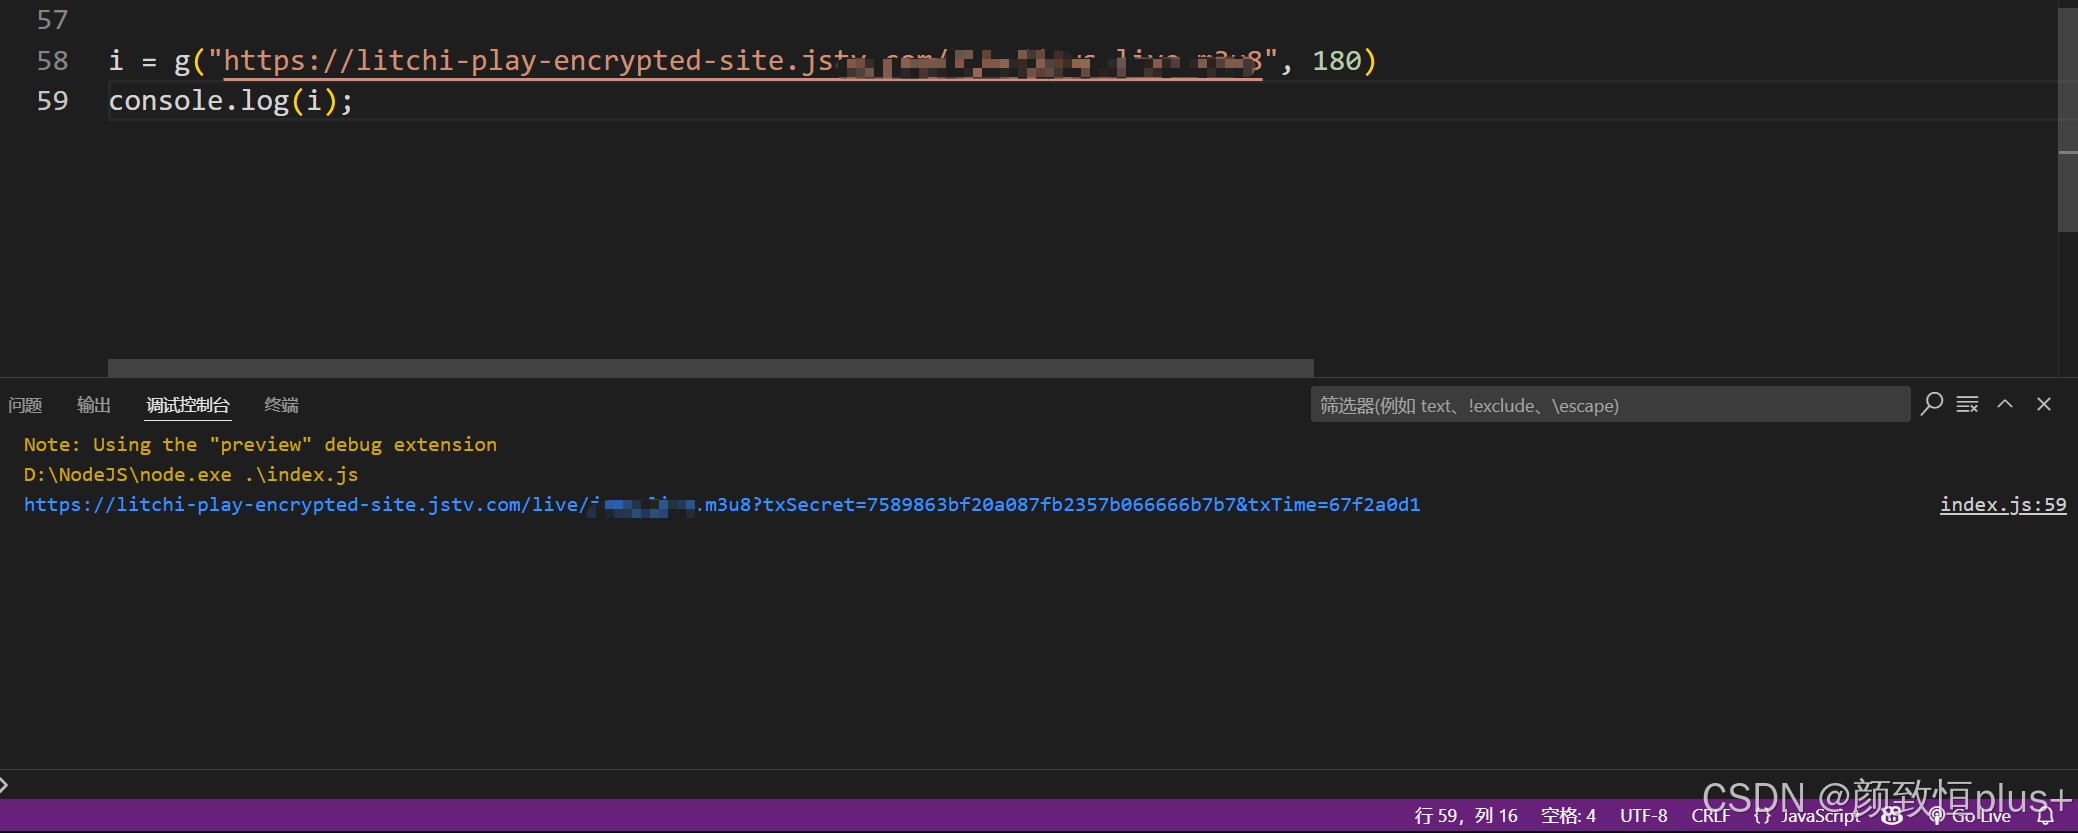
地址生成了,为什么还是 403
拿到地址后,我直接访问了一次,服务器返回 403 Unauthorized:
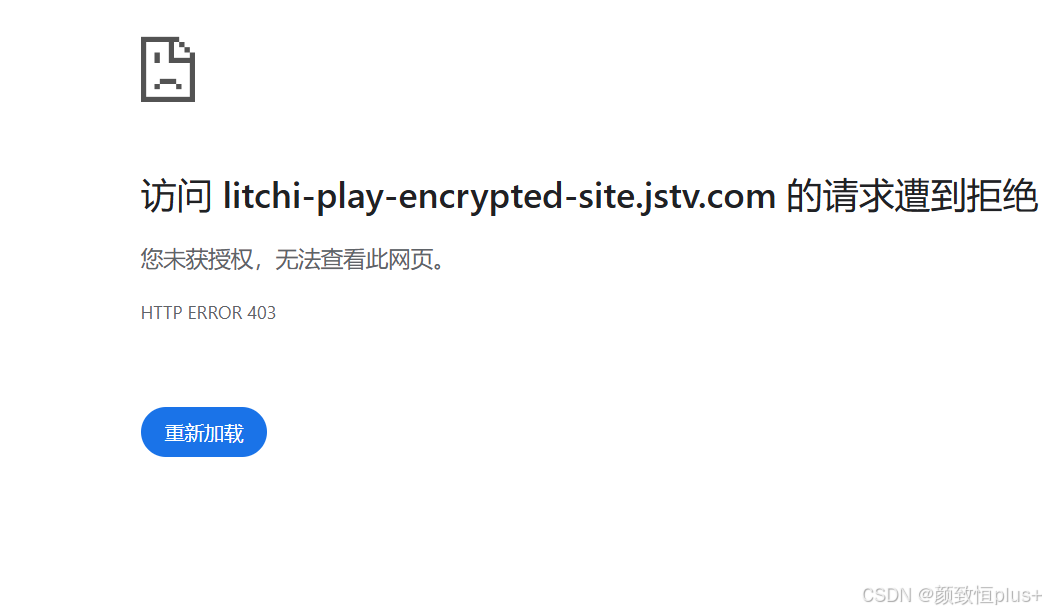
参数已经和页面请求一致,剩下最值得检查的就是请求头。对比浏览器里成功的请求后,问题落在了 Referer:服务端不只检查 URL 签名,还会判断请求是否来自正常页面。
因此,在自己的请求脚本里除了调用 JavaScript 生成最新地址,还需要带上与浏览器一致的 Referer。例如使用 Python 请求时,可以明确设置请求头:
import requests

headers = {
    "Referer": "https://对应的页面地址/",
    "User-Agent": "Mozilla/5.0",
}

response = requests.get(m3u8_url, headers=headers, timeout=15)
response.raise_for_status()
print(response.text)
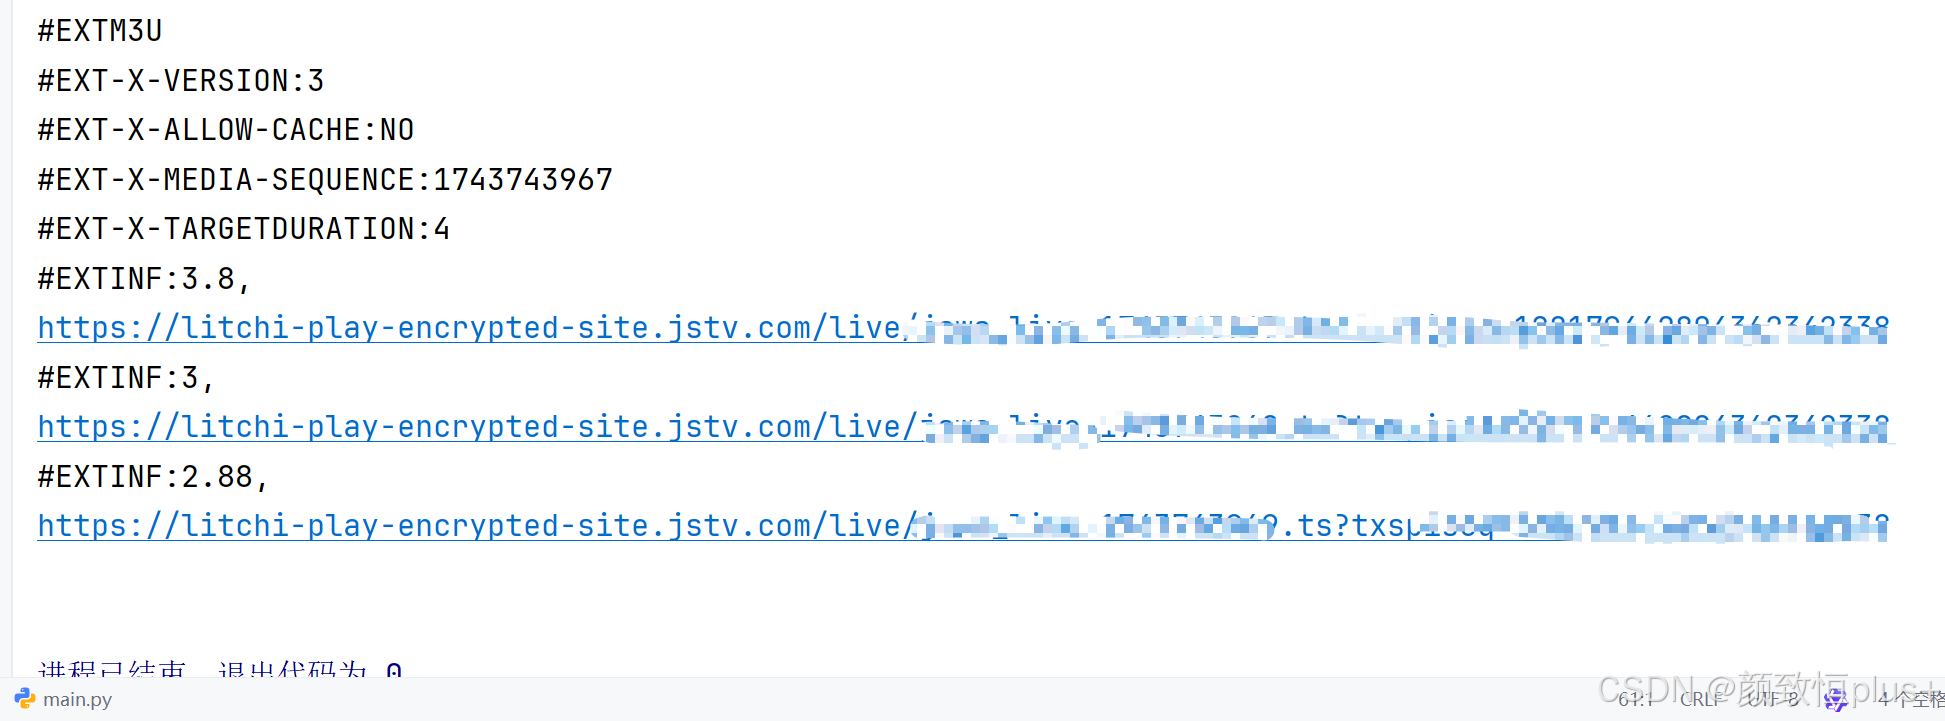
补上正确的请求上下文后,最终成功拿到了 m3u8 内容:
这次排查留下的经验
回头看,这次过程可以归纳成几步:
- 先在 Network 中找到真实请求,不要从页面元素猜播放地址。
- 从动态参数名反查打包脚本,把搜索范围缩小到具体模块。
- 通过断点确认函数的输入、输出和调用关系,再整理本地代码。
- 遇到
e[...]一类表达式时,要考虑它是不是打包器的模块运行时,不能只靠复制函数解决。 - URL 参数正确但仍然返回
403时,对比浏览器请求头,尤其留意Referer、Cookie 和 User-Agent。
最重要的一点是,每一步都用 Network 请求或断点变量来验证。这样即使网站换了文件名或重新打包,排查方法仍然能继续使用,而不是只能依赖某一段很快就会失效的代码。